Claude、ChatGPT、Grok 同晚报错:三条独立故障撞在一个时段
"上游线路或 DNS 出问题"是社区里最自然的猜测,但把三家官方公告和 Cloudflare、Google Cloud 的记录放到一张表上,这个猜测对不上。
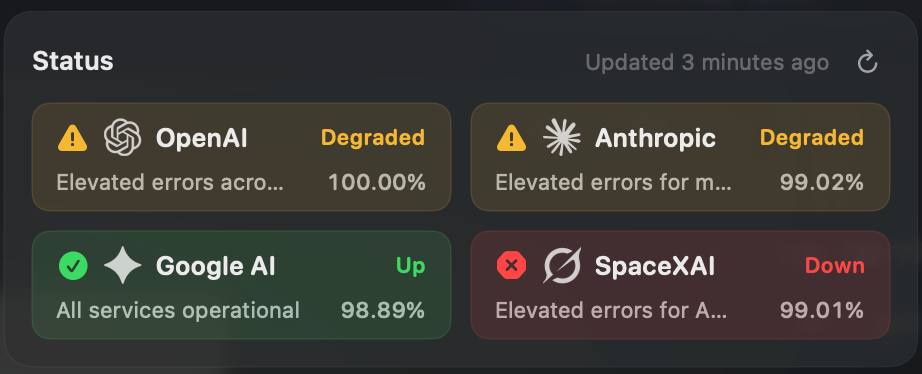
三家状态页各说各话,时间点却挤在同一小时
先把官方口径按 UTC 排一遍,括号里换算成北京时间:
- 12:37–12:56 UTC(20:37–20:56)——Anthropic 状态页记录 Claude Sonnet 5 一轮错误率升高,19 分钟后标记已解决。这其实是前一天晚上同一款模型同类事件的重演,9 月 2 日 21:17 UTC 也有一次,持续 27 分钟。
- 13:26 UTC(21:26)——Anthropic 开始调查 Claude Mythos 5.1、Fable 5.1 与 Opus 5 的错误率升高;13:41 宣布"已识别原因并正在修复";13:50 公布完整受影响清单,扩展到 Opus 4.8 与 Opus 4.6;14:49 仍在"继续处理修复"。
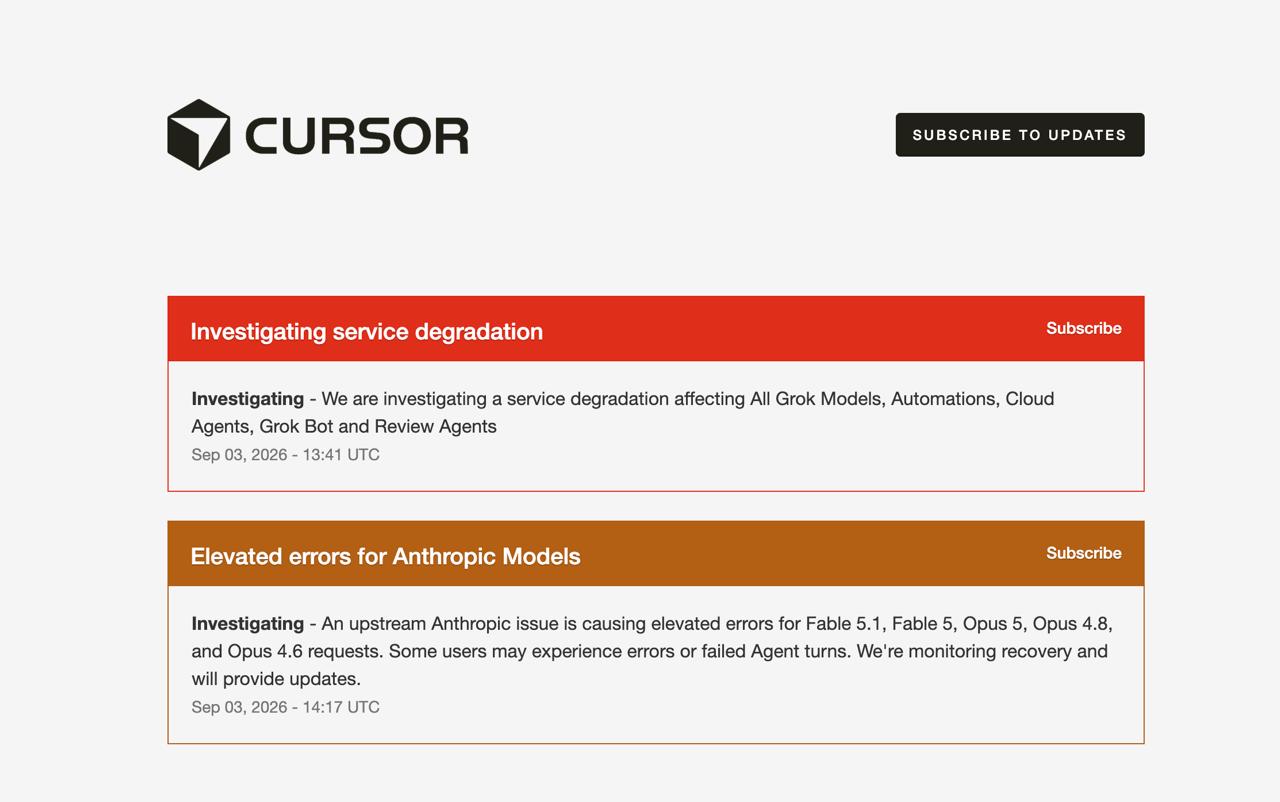
- 13:41 UTC(21:41)——Cursor 的状态页开始调查一起服务降级,波及全部 Grok 模型、Automations、Cloud Agents、Grok Bot 与 Review Agents;DownDetector 上 Grok 的用户报告超过 1000 条。
- 14:17 UTC(22:17)——Cursor 追加第二条公告,明确写着"上游 Anthropic 问题"导致 Fable 5.1、Fable 5、Opus 5、Opus 4.8、Opus 4.6 请求报错,部分用户会遇到 Agent 回合失败。
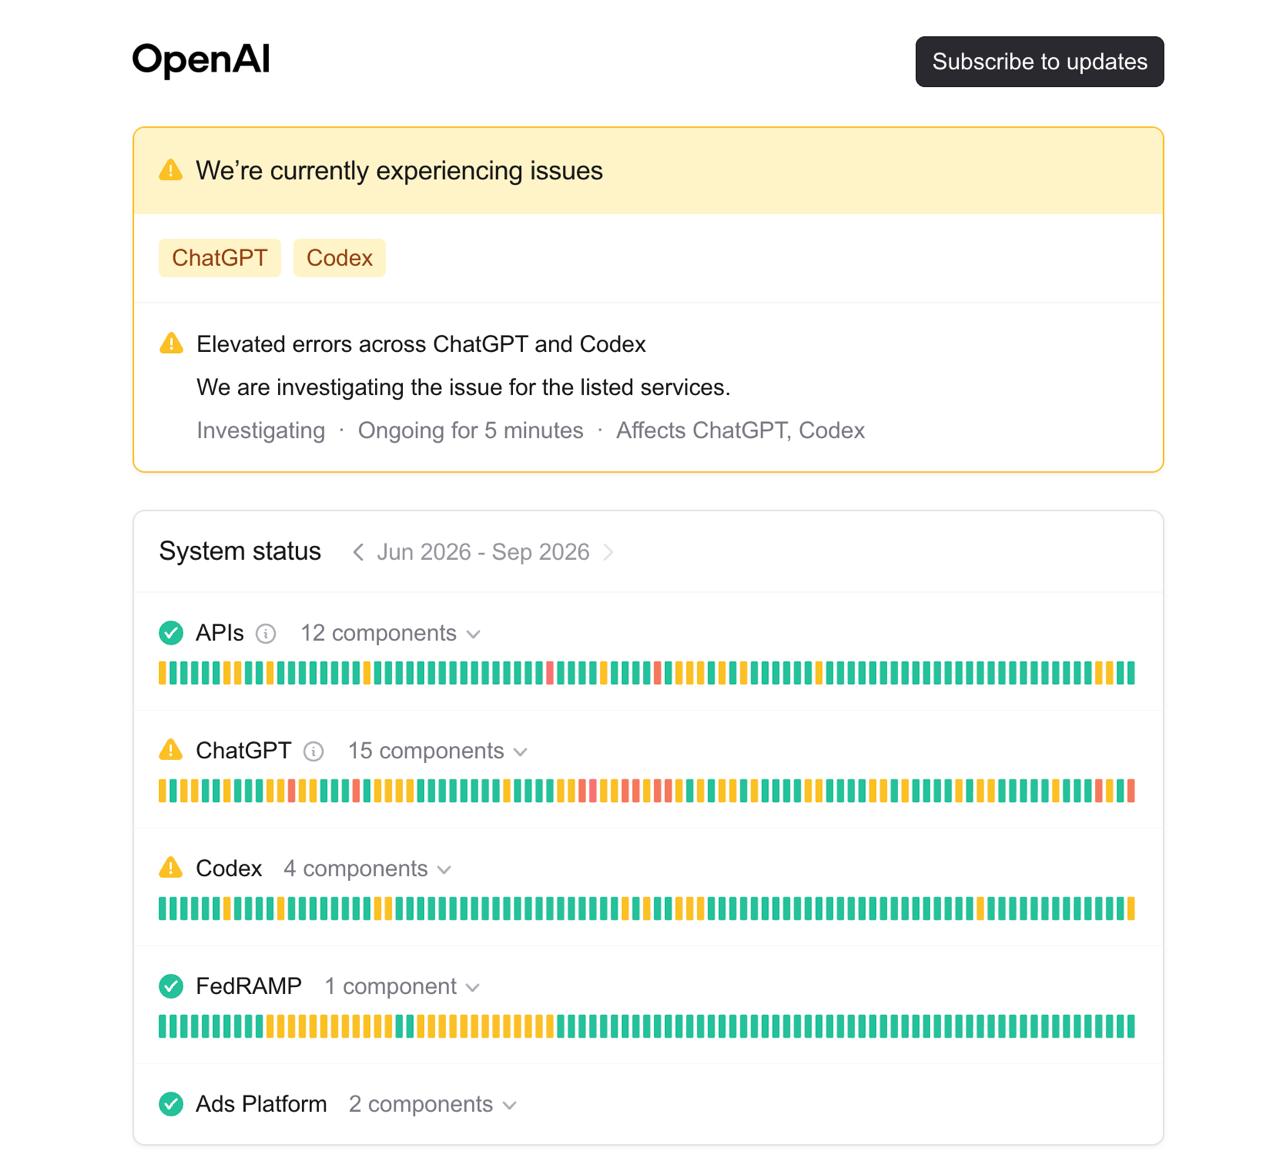
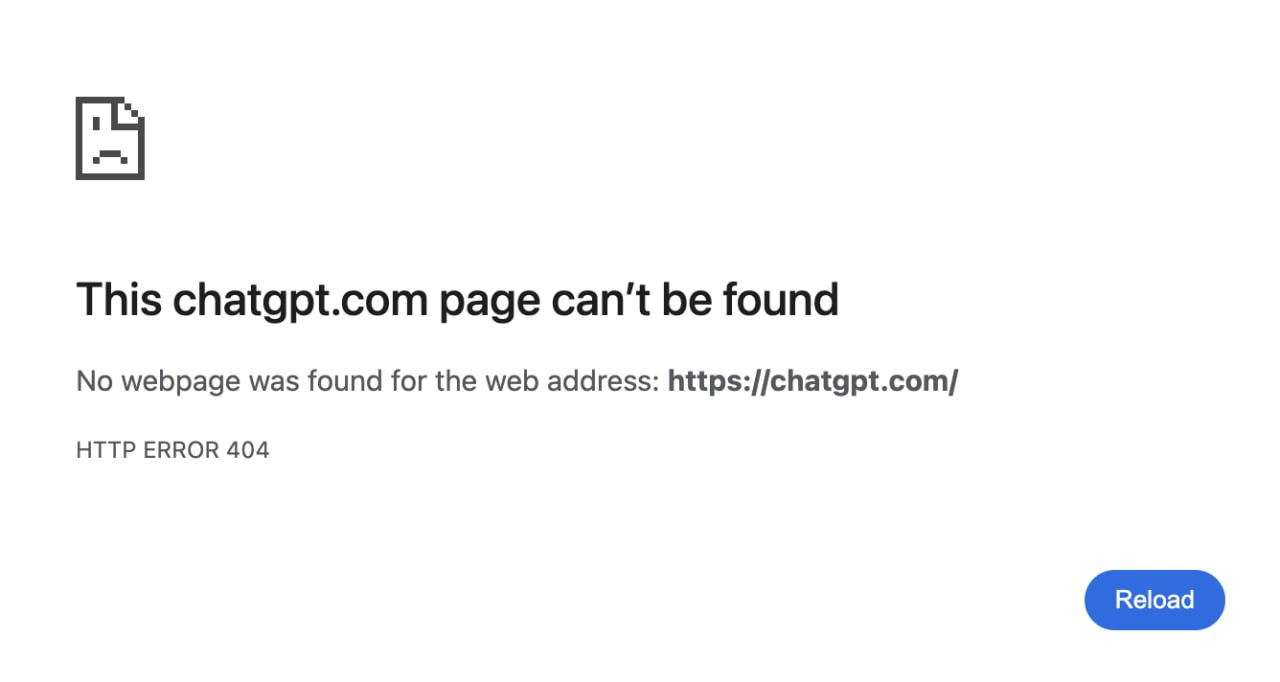
- 14:58 UTC(22:58)——OpenAI 状态页挂出"ChatGPT 与 Codex 错误率升高",状态为调查中;同一时段有用户直接打开 chatgpt.com 拿到了 HTTP 404。
Google 这一侧是个反例:聚合面板上 Google AI 全程显示正常,而社区帖标题里把 Gemini 也算进了"全挂"名单。更可能的解释是部分用户在 Antigravity 这类第三方入口遇到了问题,而不是 Gemini 本身出事。
"上游线路或 DNS 出问题"这个猜测,证据不支持
几家同时出问题,社区里最自然的反应是怀疑共同上游。这个方向值得查,但查下来对不上。
Cloudflare 当天只有两条记录:凌晨 01:55 UTC 一次 HTTP/3 影响 R2 自定义域名的事件,持续约 1 分钟;以及高雄机房从 20:30 UTC 起的计划性维护,晚于本次事故三个多小时。Google Cloud 状态页在 12:45 UTC 显示全部正常。也就是说,两家最常被点名的"共同底座"都没有与这个时间窗重叠的大范围故障。
更关键的反证来自各家自己的措辞。Anthropic 在开始调查 15 分钟后就写下"已识别原因",这是内部问题的典型节奏——如果是外部网络层出事,状态页通常会先写"正在与供应商协作"。Cursor 把自家 Anthropic 模型的报错直接归因于上游 Anthropic,但对 Grok 那条只说"服务降级",没有指向任何共同原因。OpenAI 的公告晚了一个半小时才出现,受影响范围是 ChatGPT 与 Codex,API 组件保持绿色。三家故障的组件粒度、起止时间、处理节奏都不一样,硬要找一个共同根因,反而解释不通。
那为什么总是"一起挂"
如果不是同一根因,为什么这类"全挂"帖隔几个月就出现一次?一个不太浪漫但更站得住的解释是时段。
13:00–15:00 UTC 对应美东上午 9 点到 11 点,是北美工作日开工后的第一个流量高峰,也是各家最容易触发容量边界的时段。Anthropic 这次的受影响清单几乎全是旗舰与推理密集型模型,Sonnet 5 在前一天和当天各有一次短暂报错,形态更像是负载相关的问题,而不是某条链路被切断。三家在同一个高峰时段各自碰到自己的瓶颈,从用户这头看就是"一起挂了"。
另一个放大器是中间层。Cursor 这类 IDE 同时接入四五家模型,任何一家上游报错都会在它的状态页上留下痕迹;用户看到 Cursor 里 Claude 和 Grok 都失败,很自然地把账记到"整个 AI 圈"头上,尽管两者背后的原因完全不同。聚合状态面板也是同样的效果,它把不同颜色的四个方块并排摆在一起,视觉上就是一场集体事故。
截至发稿还没收口的部分
写到这里,Anthropic 的事件仍停在"继续处理修复",OpenAI 的还是"调查中",两家都没有给出根因说明。xAI 自己的状态页无法直接访问,Grok 的情况目前只能通过 Cursor 与 DownDetector 侧面印证。国内几个论坛的帖子里,用户体验差异也很大:有人完全用不了,有人只是慢,这与"错误率升高"而非"全面宕机"的官方定性是一致的。
如果后续官方发布事故报告,最值得看的是两点:Anthropic 在 15 分钟内"识别"的那个原因到底是什么,以及 Sonnet 5 连续两天在相近时段短暂报错是否与之相关。前者决定这是一次性事故还是结构性容量问题,后者决定接下来几周同一时段要不要预留退路。